非ノイマン型コンピュータは、従来の演算器とメモリの分離による負担を見直す計算方式を広く扱う言葉です。単一の構造や製品を指す名称ではありません。本記事では、メモリ内演算、メモリ近傍演算、ニューロモーフィックを分け、デバイスと回路の構造、2026年11月時点で確認できる研究動向を説明します。
ノイマン型とは:演算とメモリを分けて結ぶ構成
ノイマン型の構成
現在のコンピュータの多くは、ノイマン型(フォン・ノイマン型)と呼ばれる構成に基づいています。演算を行うプロセッサとデータを記憶するメモリを分け、両者をバスで結ぶ構成です。IBM Researchの解説は、過去60年ほどのほぼすべてのプロセッサに見られる構成と説明しています。
ジョン・バッカスは1977年のチューリング賞講演をもとにした論文で、最も単純なノイマン型計算機を、CPU、記憶装置、両者の間で1語ずつデータを送る接続経路の三つの部分として説明しました。データだけでなく、命令やデータの場所を示すアドレスも、この経路を通って行き来します。
ノイマン型の限界:フォン・ノイマン・ボトルネック
バッカスは、この接続経路を「フォン・ノイマン・ボトルネック」と名付けました。プログラムは記憶装置の中身を書き換えることで計算を進めますが、そのためには大量の語をこの経路で往復させる必要があるという指摘です。
AIの計算では、この制約が大きく表れます。IBM Researchによると、プロセッサはメモリからモデルの重みが運ばれてくるのを待つあいだ、能力を出し切れません。AIの実行時の主なエネルギー消費はデータ転送で、メモリがプロセッサから遠いほど、データを動かすエネルギーと遅延が増えます。データ転送の効率は演算やメモリほどには向上しておらず、学習だけでなく推論も同じ影響を受けます。
非ノイマン型が目指すもの
非ノイマン型の狙いは、演算とメモリの間のデータ移動を減らすことです。メモリの中で演算するインメモリ演算や、演算器のすぐ近くにメモリを置くメモリ近傍演算によって、データ転送に使うエネルギーを減らし、ボトルネックを和らげることを目指します。
ただし、ノイマン型が不要になるわけではありません。IBM Researchは、汎用の計算にはノイマン型が適しているとし、ノイマン型と非ノイマン型のプロセッサを組み合わせて、それぞれが得意な処理を担う形を示しています。
代表的な三つのアプローチ
- アナログのメモリ内演算:NeuRRAMなどの抵抗変化メモリ方式
メモリ素子の電気的な状態を重みに対応させ、配列内で演算する方式です。データの移動を抑える一方、素子のばらつきと入出力の変換回路まで含めた設計が必要です。UC San DiegoのNeuRRAM解説は、研究チップの構造と評価を紹介しています。
- デジタルのメモリ近傍演算:IBM NorthPole
NorthPoleはデジタルSRAMを演算コアの近くに配置する推論用研究チップです。メモリ素子そのもののアナログ特性で演算する方式とは区別します。IBMの解説は、近傍演算とアナログ演算の関係を説明しています。
- ニューロモーフィック:Intel Loihi 2
Loihi 2はスパイクで情報をやり取りするニューロモーフィック研究チップです。イベント駆動の処理、局所的なメモリ、疎な通信を組み合わせます。Intelの公式発表では研究チップとソフトウェア基盤Lavaを説明しています。
ノイマン型の課題をどこから見直すのか
演算とメモリの間のデータ移動
ニューラルネットワークでは重みや中間データを繰り返し扱います。演算器が速くても、メモリから必要なデータを供給できなければ性能を生かせません。非ノイマン型の研究では、この移動の距離や回数を見直すことが重要な狙いです。
計算の配置と計算の原理
メモリと演算器を近づける変更と、メモリ配列内で電流や電圧を使って演算する変更は異なります。いずれもデータ移動の削減を狙いますが、必要な素子、回路、数値精度の扱いは同じではありません。
非同期処理だけを意味しない
ニューロモーフィックにも複数の実装があります。IBMはNorthPoleを同期式のデジタル設計と説明しています。非ノイマン型であればすべて非同期、アナログ、スパイク駆動になるという分類は適切ではありません。
アナログ・インメモリ演算の構造
抵抗・コンダクタンスへの重みの対応付け
抵抗変化メモリを用いる方式では、素子のコンダクタンスにニューラルネットワークの重みを対応させます。入力に応じた電気信号を配列に加え、得られる出力を演算結果として利用します。保存だけでなく演算に素子の物理特性を利用する点が特徴です。
配列の外側に必要な回路
実際のチップには、メモリ配列以外に入力駆動、出力検出、A/D変換、制御やデータ処理の回路が必要です。配列だけの効率が高くても、変換やデータ搬送の負担が大きければシステム全体の利点は小さくなります。
素子特性と計算精度
目標の重みを書き込む精度、素子間のばらつき、時間変化や読み出し時の誤差に対処する必要があります。アナログ計算の誤差を考慮した学習や補正も研究対象です。素子数が多いことだけで推論精度が保証されるわけではありません。
NeuRRAMとPCM方式の研究例
NeuRRAMは研究チップ
NeuRRAMは2022年に発表されたRRAMベースのcompute-in-memoryチップです。メモリ配列に加え、電圧を検出してA/D変換を行うニューロン回路を設計しています。発表論文の実証を、そのまま市販品の発売や量産開始と読み替えることはできません。
PCMを用いるアナログAI
IBMは相変化メモリ(PCM)のコンダクタンスに重みを保持する方式を研究しています。材料の状態を利用して重みを表すため、デジタルSRAMに数値を格納して論理回路で計算する方式とは実装原理が異なります。IBM Analog AIが研究対象を紹介しています。
推論と学習を分けて評価する
推論では学習済み重みを使い、学習では重みの更新も必要になります。書き込みの負担や精度要件が異なるため、推論に適したデバイスがそのまま学習にも有利とは限りません。どの工程をハードウェアで実行した結果かを確認します。
NorthPoleのデジタル近傍演算
局所メモリと演算コア
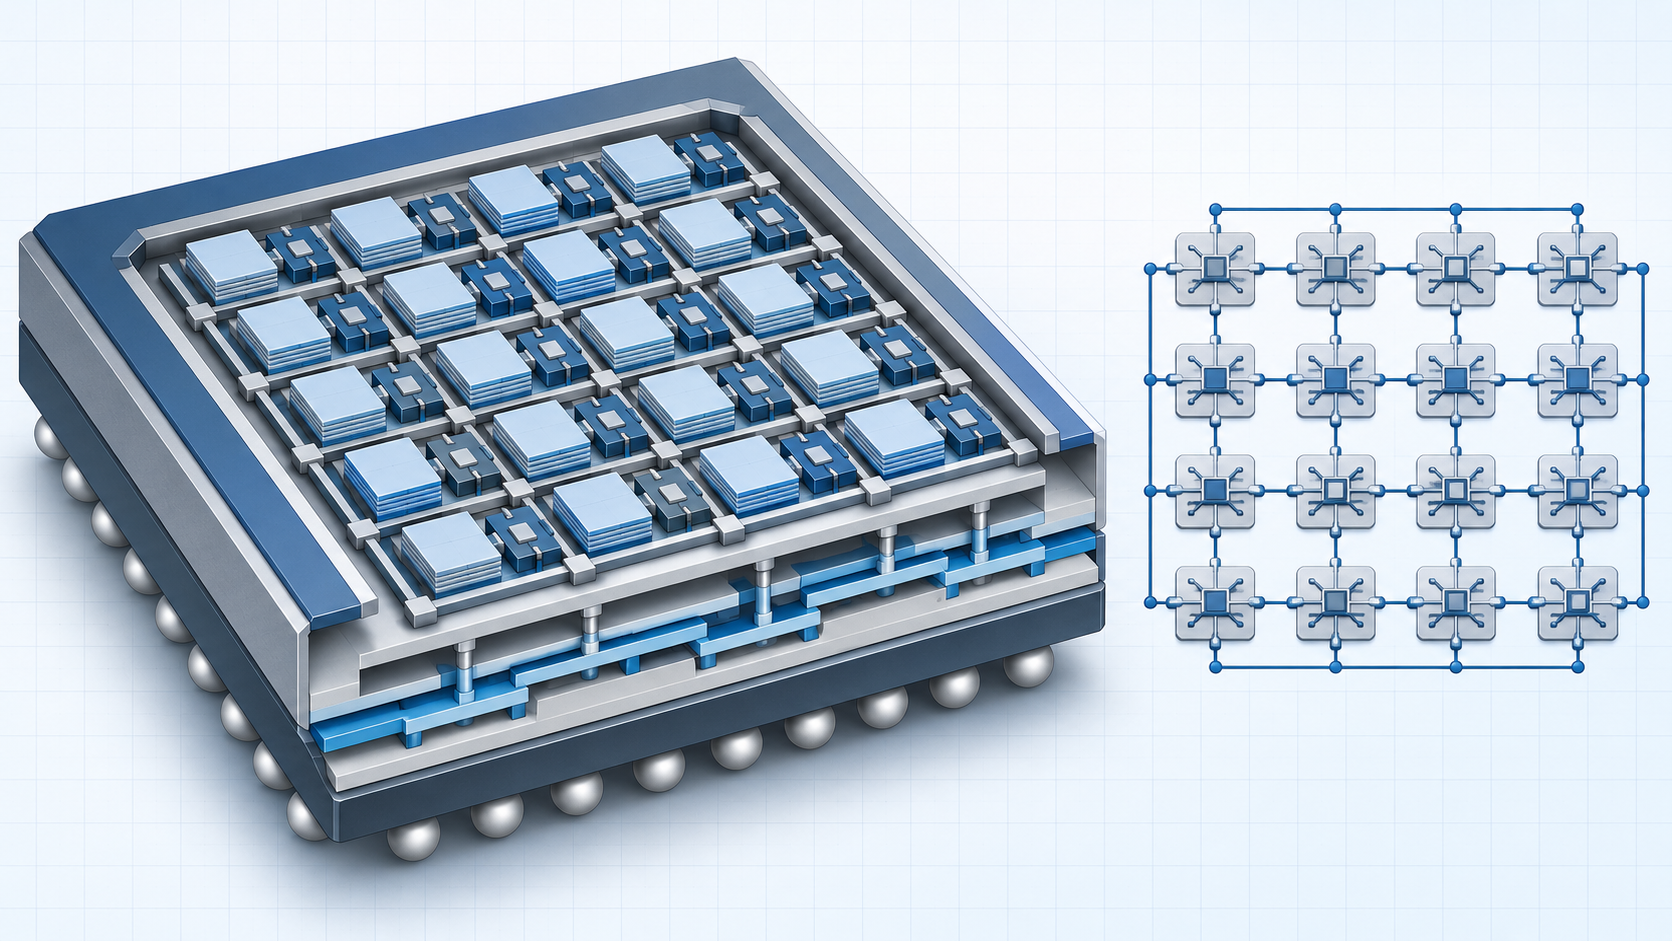
NorthPoleはコアと局所メモリを多数配置し、ネットワークでつなぐアーキテクチャです。演算で使う情報をチップ内に置き、外部との重み移動を減らす方向です。メモリと演算の距離を短くする点に着目して理解すると、アナログ方式との違いが明確になります。
同期式の推論アーキテクチャ
NorthPoleは脳から着想を得た設計でも、Loihi 2と同じスパイキング方式ではありません。通常のニューラルネットワークの推論を対象とするデジタル回路です。ニューロモーフィックという広い表現だけで、演算方式まで同一視しないことが重要です。
容量とモデル配置の制約
局所メモリに重みを置く設計では、モデルがチップの記憶容量に収まるかが重要です。複数チップに分ければ、チップ間通信も評価対象に入ります。単体の演算効率だけで、あらゆる大規模モデルに有利と結論付けることはできません。
Loihi 2のニューロモーフィック演算
スパイクによる情報伝達
スパイキングニューラルネットワークでは、イベントとして発生するスパイクを用いてニューロン間で情報を伝えます。入力の時間変化や疎な活動を利用する処理と関係が深く、通常のニューラルネットワークの行列演算をそのまま移す設計とは異なります。
局所状態とイベント駆動
Loihi 2ではニューロンや結合に関する状態を保持し、イベントに応じて処理を進めます。利点はワークロードの活動の疎さや通信量にも左右されます。脳を参考にしたという理由だけで、すべてのAI処理の消費電力が下がると断定することはできません。
Lavaと研究利用
IntelはLoihi 2とともにLavaを公開し、神経系に着想を得た処理の開発を支援しています。チップだけでなく、モデルの表現、学習、マッピングの仕組みも必要です。研究用システムの利用と、一般向け半導体製品の購入・採用は区別します。
2026年の研究動向と実用化の課題
アナログとデジタルの役割分担
2026年5月に紹介されたEAGLE研究は、アナログCIMとRISC-Vベースのプログラマブルなマルチコアを組み合わせます。行列演算に向く部分と、活性化関数など別の演算が必要な部分を分担する設計です。EAGLEの論文概要は、モデル全体を処理するための柔軟性を課題として扱っています。
チップとシステムの評価を揃える
精度、モデル、バッチサイズ、メモリ容量、周辺回路、通信、ホスト側の処理を含めて比較する必要があります。異なる評価条件のTOPS/Wや推論速度を並べるだけでは、方式間の優劣を判断できません。
用途に応じて使い分ける
メモリ内演算、近傍演算、イベント駆動は、データ移動の削減という接点を持ちます。一方で必要なデバイスとソフトウェアは異なります。汎用CPUの一括置換と考えるよりも、対象モデルと処理の特徴に合うアクセラレータとして評価することが大切です。
関連動画と参考資料
Architecture All Access: Neuromorphic Computing Part 2(Intel Technology)です。Loihi 2、非同期通信、コア内メモリの役割を公式に解説しています。
IBM Research:ノイマン型の構成とAI計算のボトルネック
J. Backus:Can Programming Be Liberated from the von Neumann Style?(1978)